Insights
In ChatGPT-Antworten gefunden werden: Warum optimierte Inhalte trotzdem unsichtbar bleiben
Eine robots.txt aus der Zeit vor den Sprachmodellen sperrt heute die KI-Crawler aus, ohne dass es jemand merkt. Zwei technische Signale entscheiden, ob Ihr Fachwissen zitiert wird.
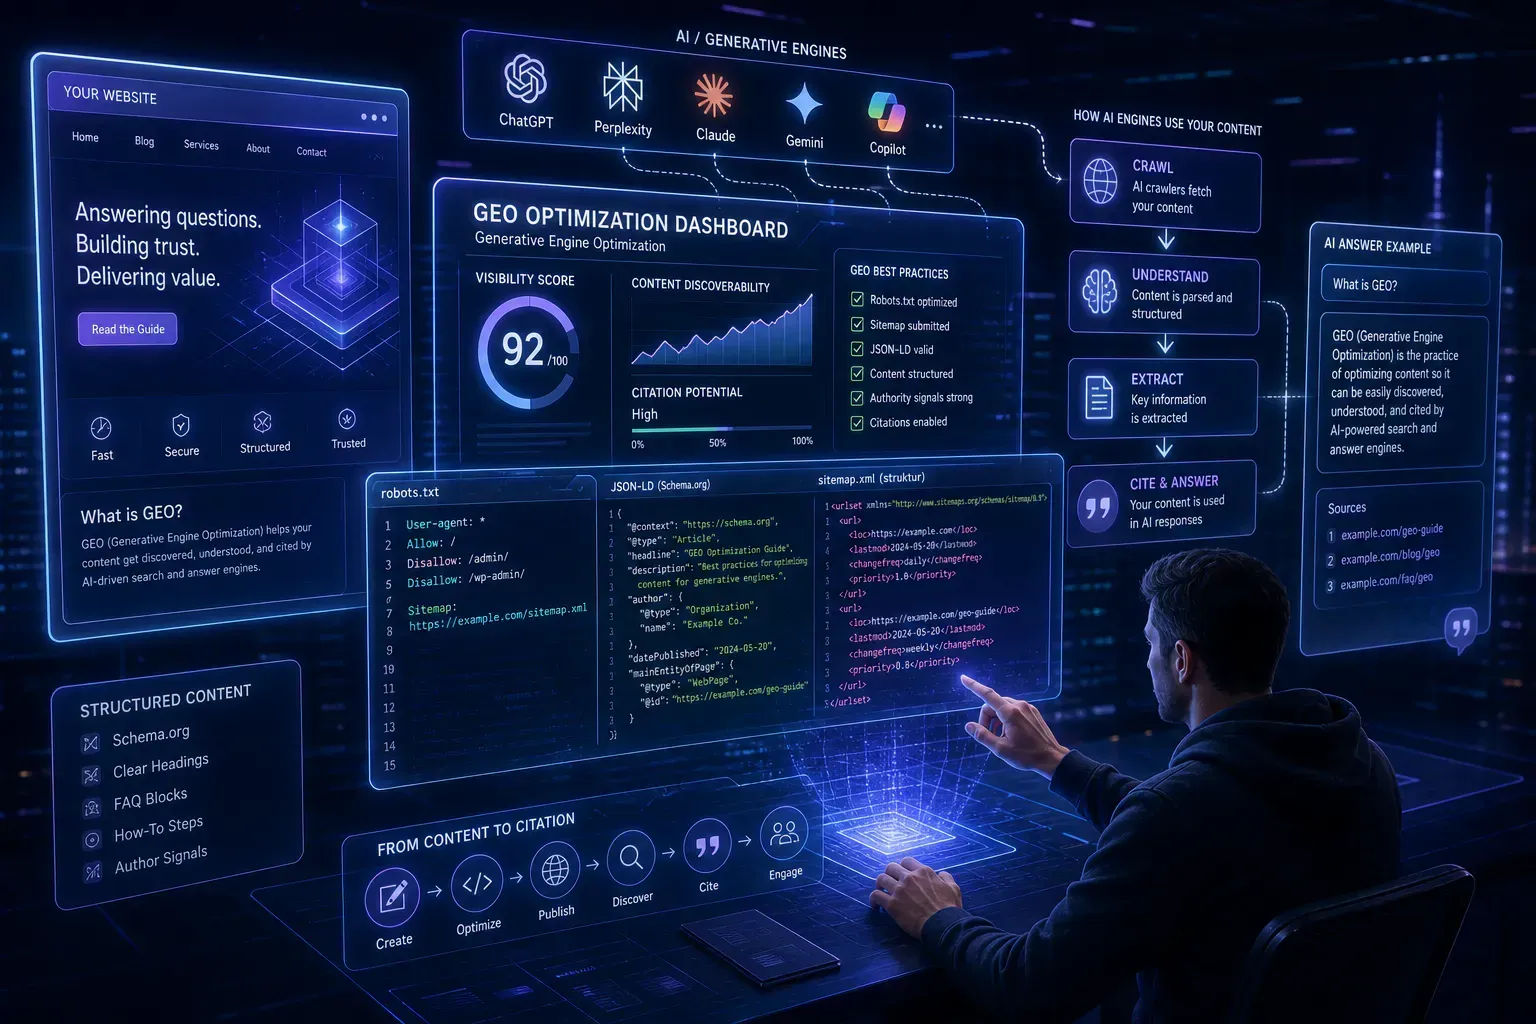
Gute Fachtexte bleiben in den Antworten von ChatGPT, Perplexity oder Google unsichtbar, wenn die technischen Signale fehlen, mit denen KI-Systeme eine Seite lesen, einordnen und zitieren. Wer in KI-Antworten vorkommen will, muss deshalb beides zugleich richtig machen: Inhalte, die eine Frage direkt beantworten, und eine Website, die Crawlern den Zugang und die Einordnung erleichtert.
Generative Engine Optimization im B2B: was KI-Systeme lesen können
KI-Suchsysteme zitieren Quellen, die sie verstehen. Strukturierte Daten nach Schema.org, als JSON-LD in die Seite eingebettet, sagen einem Crawler, dass es sich um einen Artikel handelt, wer ihn verantwortet und welche Organisation dahintersteht. Für Fachinhalte sind die Typen Article, FAQPage und Organization relevant. Ein Beispiel für einen Artikel:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Prüfprotokolle offline erfassen: was die App können muss",
  "author": { "@type": "Organization", "name": "Fachredaktion" }
}
Ohne dieses Markup ist der beste Text für eine Maschine ein unstrukturierter Block, aus dem sie Autor, Datum und Thema raten muss. Mit Markup wird er zu einer Quelle mit Herkunft, und Herkunft ist das, was ein KI-System braucht, um zu zitieren, statt nur zu paraphrasieren.
robots.txt: den KI-Crawlern nicht versehentlich die Tür zusperren
Viele Unternehmen sperren KI-Crawler aus, ohne es zu wollen. Eine robots.txt, die vor Jahren gegen Scraper geschrieben wurde, blockiert heute GPTBot, ClaudeBot oder PerplexityBot, und die Inhalte tauchen in keiner KI-Antwort auf, egal wie gut sie sind. Wer sichtbar sein will, erlaubt diese Crawler ausdrücklich und hinterlegt die Sitemap:
User-agent: *
Allow: /

User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

Sitemap: https://www.example.com/sitemap.xml
Das ist eine Abwägung, keine Pflicht. Es gibt gute Gründe, bestimmte Bereiche vor Crawlern zu schützen. Nur sollte die Entscheidung bewusst fallen und nicht als Nebenwirkung einer alten Konfiguration.
Was Unternehmen anders machen, die tatsächlich zitiert werden
Die Unternehmen, deren Inhalte in KI-Antworten auftauchen, schreiben nicht besser als andere. Sie schreiben für dieselbe Frage, die ein Kunde einem KI-Modell stellt, und beantworten sie im ersten Absatz statt im letzten. Jeder Abschnitt steht für sich, damit ein Modell ihn herauslösen kann, ohne den ganzen Artikel zu brauchen. Fachbegriffe wechseln nicht zwischen Synonymen, denn ein Modell erkennt „Materialzeugnis" und „Werkstoffnachweis" nicht zwangsläufig als dasselbe. Dazu kommen die technischen Signale: strukturierte Daten, eine saubere interne Verlinkung und eine robots.txt, die KI-Crawler zulässt.
Und sie messen. Ob eine Seite von Menschen, von Suchmaschinen oder von KI-Crawlern gelesen wird, steht in den Serverprotokollen. Wer das nicht auswertet, optimiert im Blindflug. Wir haben diese Messung in die Content Engine eingebaut, ein Modul, das in der eigenen Website des Unternehmens läuft, Artikel mit Briefing, Lektorat und Bild erstellt, im Blog und auf LinkedIn veröffentlicht und für jeden Beitrag ausweist, ob Menschen, Suchmaschinen oder KI-Modelle ihn abrufen. Der Effekt von Schema-Markup oder einer geänderten robots.txt wird dadurch sichtbar statt vermutet.
Häufige Fragen zu GEO und KI-Sichtbarkeit
Worin unterscheidet sich GEO von SEO?
Suchmaschinenoptimierung zielt auf eine Position in der Trefferliste. Generative Engine Optimization zielt darauf, in einer generierten Antwort als Quelle genannt zu werden. Die Grundlagen überschneiden sich; GEO verlangt zusätzlich, dass Inhalte zitierfähig und maschinenlesbar sind.
Welche Schema-Typen sind am wichtigsten?
Article für redaktionelle Inhalte, FAQPage für Fragen und Antworten, Organization für den Kontext, wer hinter der Seite steht.
Wie finden Sie heraus, ob Ihre Inhalte bereits zitiert werden?
Stellen Sie die Fragen Ihrer Kunden selbst an ChatGPT und Perplexity und prüfen Sie, ob Ihre Domain genannt wird. Verlässlicher ist der Blick in die Serverprotokolle: Dort sehen Sie, welche KI-Crawler welche Seiten abrufen.
Reicht die robots.txt, oder brauchen Sie auch strukturierte Daten?
Beides. Die robots.txt regelt den Zugang, strukturierte Daten regeln das Verständnis. Eines ohne das andere bringt wenig.
Rufen Sie die robots.txt Ihrer Website auf und prüfen Sie, ob GPTBot, ClaudeBot und PerplexityBot dort ausgesperrt sind. Dann öffnen Sie den meistgelesenen Fachartikel und sehen nach, ob er strukturierte Daten trägt. Mit diesen beiden Befunden buchen Sie den kostenlosen Potenzial-Check, eine halbe Stunde, in der wir gemeinsam einschätzen, was Ihre Inhalte von der Sichtbarkeit in KI-Antworten trennt.