Insights
Leitplanken für KI-Agenten: empfehlen ja, entscheiden nein
Was der Bau eines Handelsleitstands über KI-Agenten lehrt: Das Modell empfiehlt, der Code entscheidet, und jede Nicht-Handlung wird protokolliert.
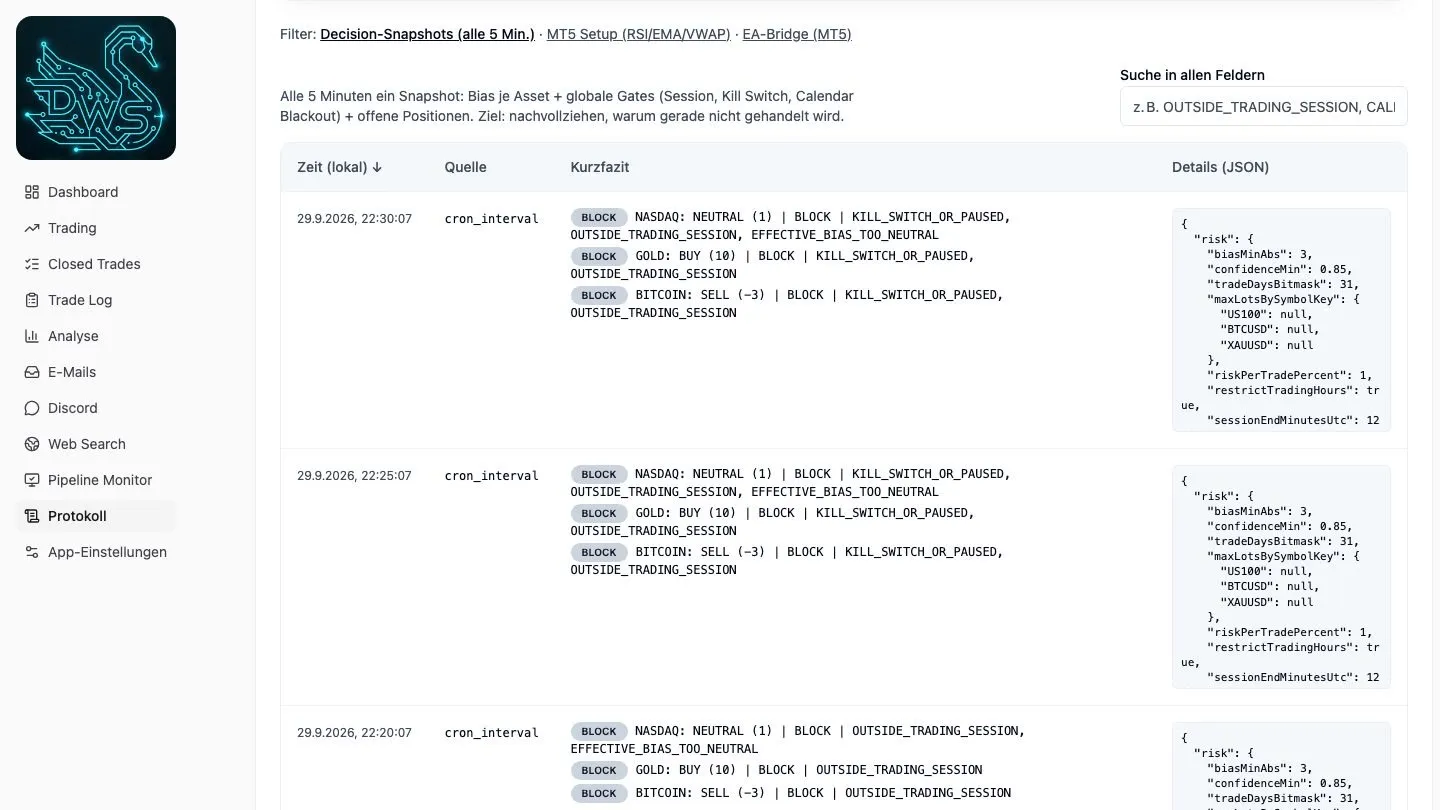
Ein KI-Agent darf empfehlen. Entscheiden und ausführen sollte er nur innerhalb von Leitplanken, die im Code stehen und nicht im Prompt. Wie viel es in der Praxis bedeutet, habe ich erst beim Bau eines Handelsleitstands verstanden, in dem ein Sprachmodell über echte Orders mitredet.
Eigenes Experiment. derWeisserSchwan ist ein Projekt, das ich von März bis Mai 2026 gebaut und danach archiviert habe1. Es geht nicht um Trading-Ergebnisse, sondern um die Architektur. Die Screenshots der Web-Anwendung stammen aus einer lokalen Instanz mit Demodaten. Der Screenshot des MetaTrader-Terminals ist echt, Konto und Broker sind unkenntlich gemacht.
Warum ausgerechnet ein Handelssystem
Ein Handelssystem ist das drastischste Beispiel für die Frage, wie viel Entscheidung man einem KI-Agenten gibt. Jeder versteht sofort, was passiert, wenn die Leitplanke fehlt: Eine falsche Order kostet Geld, und zwar in Sekunden. In einer Kanzlei oder einem Produktionsbetrieb ist der Schaden langsamer, folgt aber demselben Muster. Ein Modell schlägt etwas vor, und irgendwo wird aus dem Vorschlag eine Handlung.
Das System verdichtet Finanz-Newsletter aus einem Postfach, Stimmung aus einem Chat-Kanal und eine Websuche nach Breaking News zu einer Tagesrichtung für drei Instrumente: NASDAQ, Gold und Bitcoin1. Ein eigener Expert Advisor im MetaTrader 5 setzt die Orders um. Das Sprachmodell ist Google Gemini1.
Die Rollen: Richtung ja, Order nie
Die wichtigste Entscheidung fiel vor der ersten Zeile Code. Das Sprachmodell liefert eine Richtung je Instrument, einen Score von −10 bis +10 mit Begründung und Konfidenz1. Es darf den Handel bremsen, etwa wenn die Stimmung im Chat kippt. Eine Order auslösen darf es nie1.
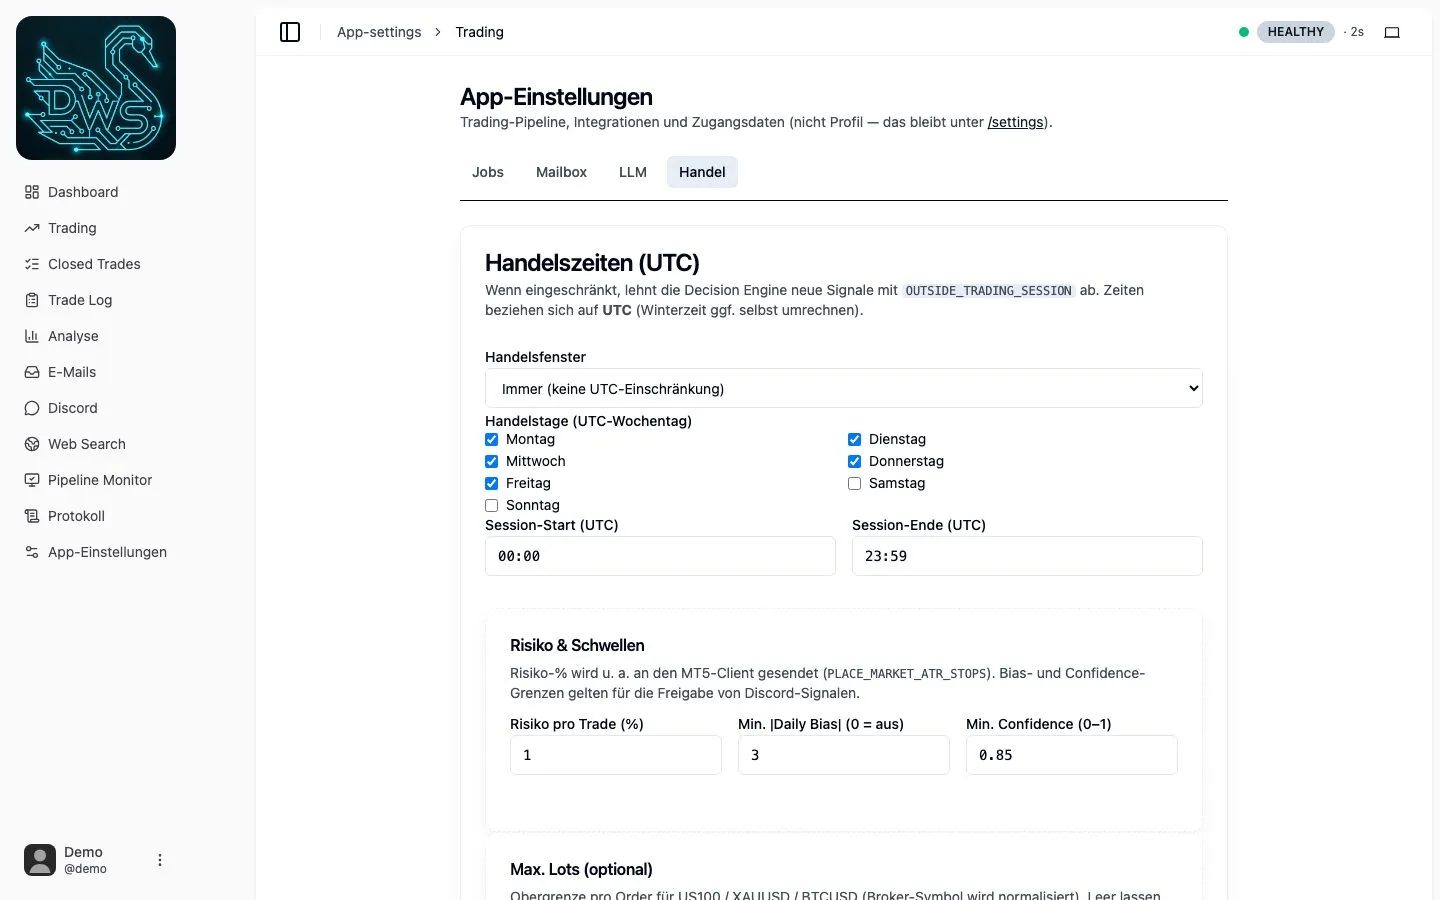
Einstieg, Stop und Ziel folgen festen Regeln im Terminal. Das Modell sagt „heute eher kaufen“, die Regeln sagen, ob, wann und wie viel. Nur an dieser Stelle bleibt ein Fehler des Modells begrenzt, egal wie überzeugend seine Begründung klingt.
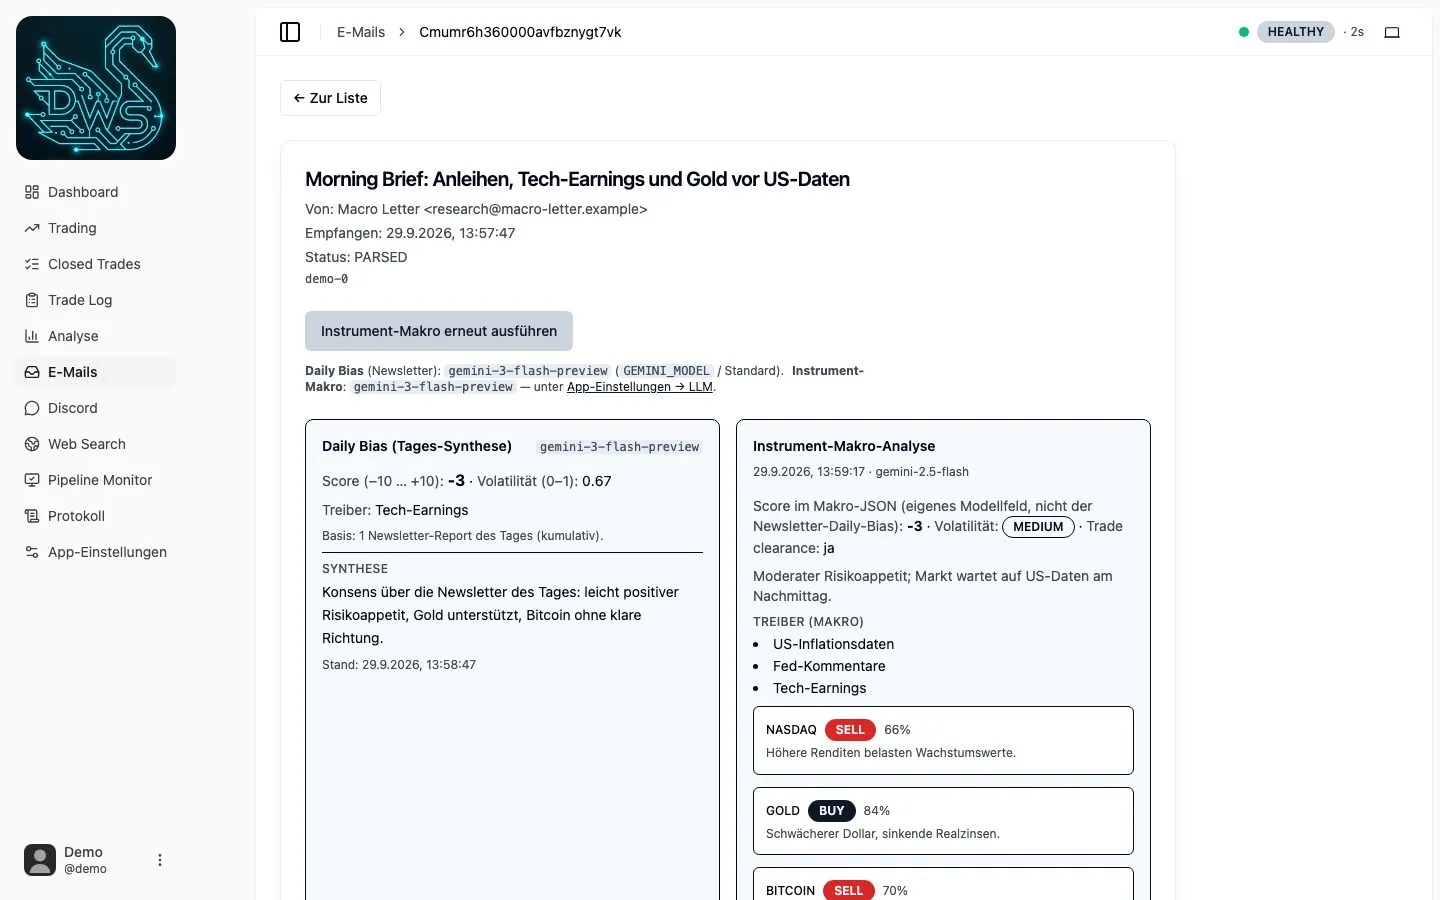
Ein Detail hat mich dabei überrascht: Die Chat-Stimmung darf die Tagesrichtung nur befristet dämpfen, mit einer Hysterese und automatischem Ablauf1. Aus Chat-Text entsteht nie ein Einstieg. Das Äußerste, was die Chat-Stimmung auslösen kann, ist, dass eine bereits laufende Runner-Position früher geschlossen wird1.
Ganz sauber ist die Trennung im Code allerdings nicht, und das gehört zur Ehrlichkeit dieses Experiments. Meldet die Websuche einen Schock, darf das Modell die Richtung eines Instruments sofort drehen, und der Expert Advisor setzt den Risikofaktor für diese Richtung auf das 1,5-Fache, bei einer als kritisch eingestuften Meldung auf das Doppelte1. Die Order löst weiterhin der Code nach seinen Regeln aus. An dieser Stelle gibt das Modell aber mehr vor als eine Bremse. Heute würde ich sie anders bauen: Ein Schock darf das Risiko senken oder den Handel anhalten, eine Erhöhung braucht die Freigabe eines Menschen.
Die OWASP-Liste der Risiken für LLM-Anwendungen führt genau das als eigenen Punkt: „Excessive Agency“, also zu viel Handlungsspielraum für ein Modell2. Die Gegenmaßnahme dort ist dieselbe. Rechte eng fassen und die Wirkung einer Handlung außerhalb des Modells prüfen.
Die Anbindung an MetaTrader 5: wo die Orders wirklich entstehen
Echte Orders laufen über einen eigenen Expert Advisor im MetaTrader-5-Terminal, die DWS_Bridge in Version 2.35, geschrieben in MQL51. Die Web-Anwendung hat keinen Zugriff auf das Terminal. Die Verbindung geht immer vom Terminal aus: Es fragt alle 15 Sekunden nach neuen Befehlen, meldet alle 8 Sekunden die offenen Positionen, bestätigt jeden abgeholten Befehl einzeln und schickt nach jedem geschlossenen Trade Einstieg, Ausstieg, ursprünglichen Stop und den größten zwischenzeitlichen Gewinn und Verlust zurück1. MetaTrader erlaubt solche Aufrufe nur an eine freigegebene Adresse, dazu kommt ein gemeinsamer Schlüssel.
Einen Einstieg löst der Expert Advisor nach festen Regeln selbst aus. Zu jeder geschlossenen Fünf-Minuten-Kerze prüft er, ob die Tagesrichtung aus der Web-Anwendung für dieses Instrument auf Kauf oder Verkauf steht und ob der Risikofaktor größer null ist. Nur dann kommen die technischen Bedingungen: ein RSI-Signal über 14 Perioden als Auslöser, der Trend aus den gleitenden Durchschnitten über 50 und 200 Perioden und der Abstand zum volumengewichteten Durchschnittspreis des Tages1. Passt alles, platziert er die Orders, und zwar mit Stop Loss und Take Profit direkt in der Order beim Broker1.
Aus der Web-Anwendung kommen nur Zustände und wenige feste Befehle: Richtung und Risikofaktor je Instrument, ein Wiedereinstieg nach einem Stop, der erst nach Preisbestätigung ausgelöst wird, das vorzeitige Schließen einer Runner-Position und die Notbremse1. Jeder dieser Befehle entsteht in Code, der die Antwort des Modells nur als eine Eingabe unter mehreren liest.
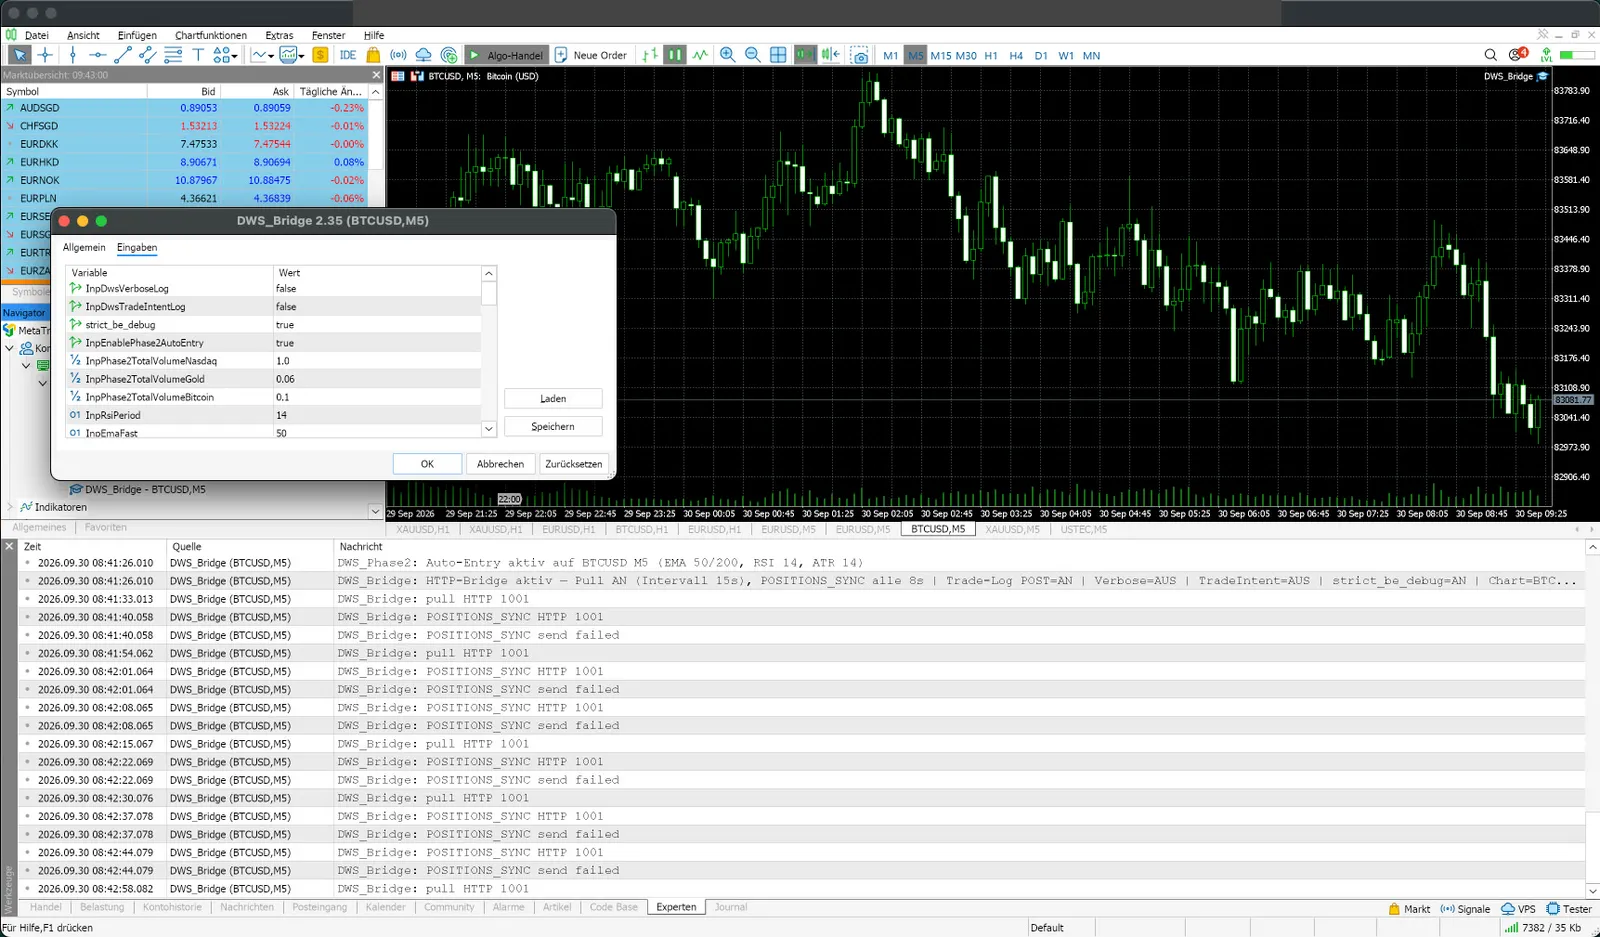
Nach der Archivierung fragt die Bridge weiter im Takt nach Befehlen und bekommt keine Antwort mehr. Für genau diesen Zustand sind die festen Stops beim Broker da.
Leitplanken für KI-Agenten gehören in den Code
Eine Leitplanke im Prompt ist eine Bitte. Eine Leitplanke im Code ist eine Grenze. Im Leitstand stecken vier davon, und keine hängt davon ab, dass das Modell sich an eine Anweisung hält.
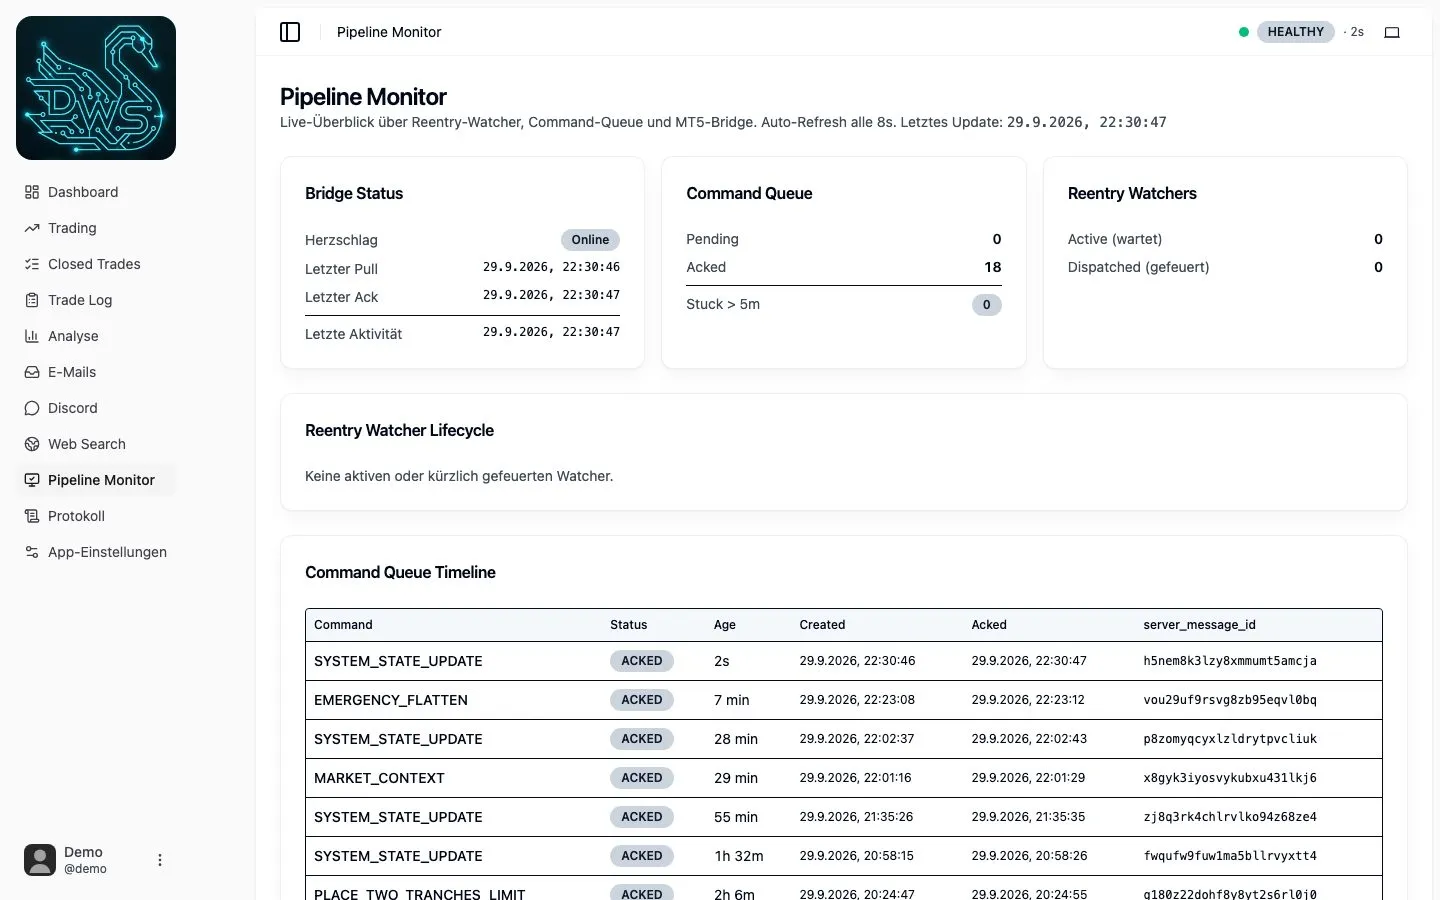
Befehle mit Quittung. Der Expert Advisor holt Befehle aus einer Warteschlange ab und bestätigt jeden einzelnen (Pull und Ack)1. Die Web-Anwendung schiebt nichts ins Terminal. Kommt keine Quittung, gilt der Befehl als nicht ausgeführt, und das ist sichtbar.
Kill-Switch. Ein Schalter im Leitstand blockiert neue Einstiege sofort, daneben stehen „alle Positionen schließen“ und ein Reset der Tagesrichtung1.
Feste Stops beim Broker. Jede offene Position trägt Stop Loss und Take Profit direkt beim Broker1. Fällt die Verbindung zwischen Anwendung und Terminal aus, laufen die Positionen regelkonform weiter, statt auf die nächste Anweisung zu warten.
Ein Protokoll für jeden Befehl. Jeder Befehl an das Terminal wird mit Zeitpunkt, Inhalt und Quittung festgehalten1.
Der wichtigste Log ist der, warum nichts passiert ist
Das Protokoll der ausgeführten Befehle hätte ich in jedem Fall gebaut. Der eigentliche Gewinn kam von einer anderen Tabelle: Alle fünf Minuten hält das System fest, warum es gerade handelt oder warum nicht1. Richtung zu schwach, außerhalb der Handelszeit, Kill-Switch aktiv, Konfidenz unter der Schwelle.
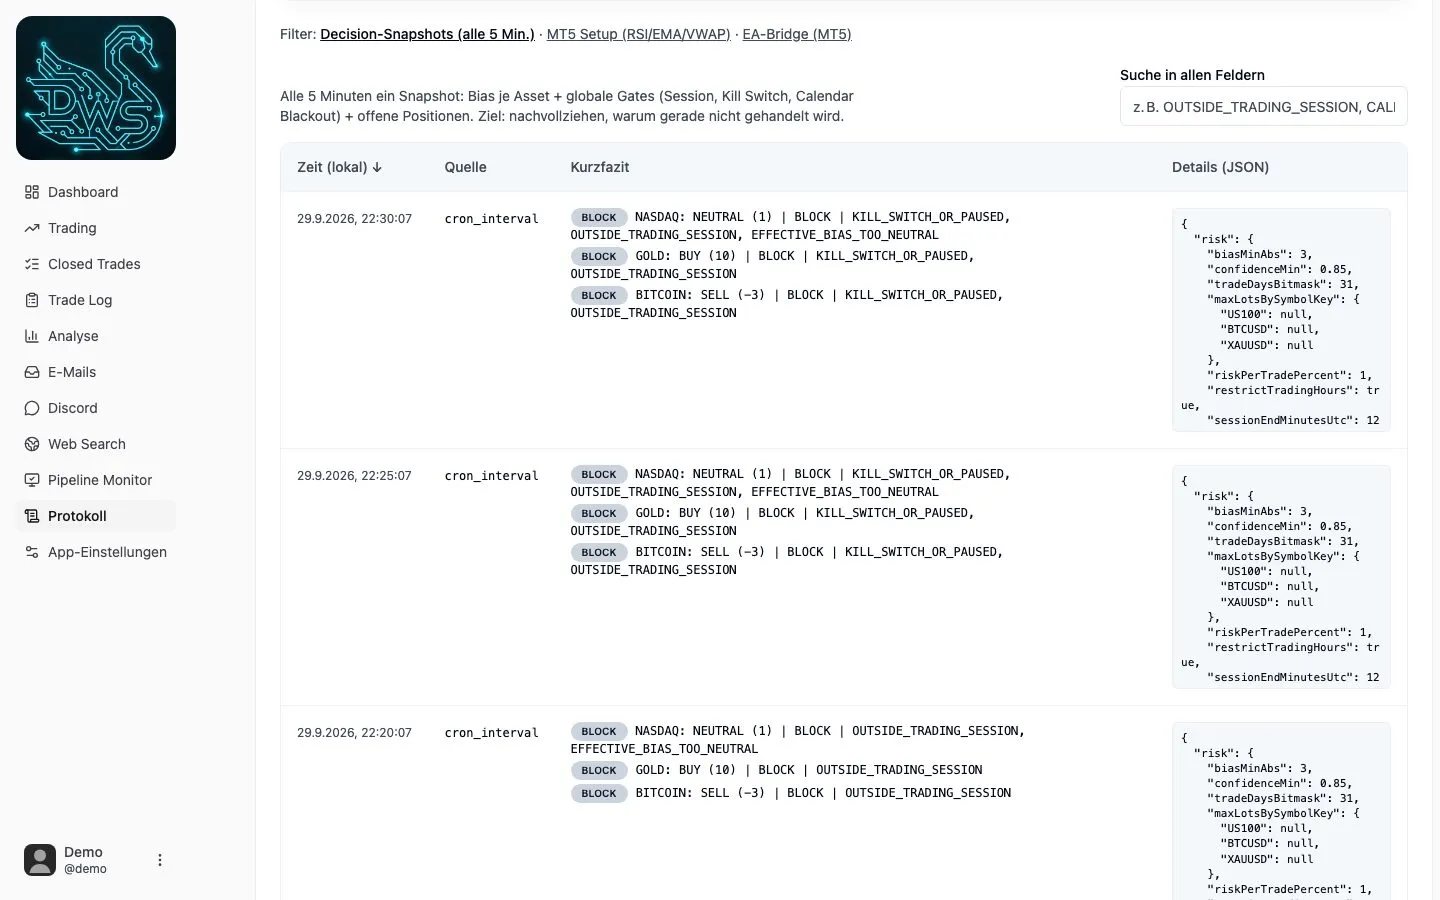
Diese Snapshots beantworten die erste Frage nach jedem Vorfall, ohne Rekonstruktion aus Logdateien. Ein Agent, der nichts tut, sieht von außen genauso aus wie ein Agent, der kaputt ist. Erst der „warum nicht“-Eintrag unterscheidet die beiden.
Die EU-KI-Verordnung (Verordnung (EU) 2024/1689) verlangt für Hochrisiko-Systeme beides, was hier entstanden ist: automatische Aufzeichnungen über den Betrieb (Artikel 12) und eine wirksame menschliche Aufsicht, die ein System auch anhalten kann (Artikel 14)3. Ein Leitstand für den Eigengebrauch fällt nicht darunter, die Anforderungen passen trotzdem genau.
Was sich auf andere KI-Agenten übertragen lässt
Die Fragen dahinter stellen sich bei jedem KI-Agenten, der mehr tut als Text zu schreiben: dem Assistenten, der Mandantenanfragen vorsortiert, oder dem Agenten, der Bestellungen anlegt.
Aus dem Experiment nehme ich vier Regeln mit:
- Trennen Sie Empfehlung und Ausführung. Das Modell liefert einen Vorschlag mit Begründung. Die Ausführung liegt in Code, der die Regeln kennt und das Modell nicht braucht.
- Geben Sie dem Modell eine Bremse, kein Gaspedal. Ein Agent darf Abläufe anhalten oder zur Prüfung vorlegen. Neue Handlungen auslösen oder Risiken erhöhen darf er nur in klar begrenzten Fällen, und die Schock-Ausnahme in meinem System ist die Stelle, die ich als Erstes zurückbauen würde.
- Protokollieren Sie auch das Nicht-Handeln. Ohne „warum nicht“ ist jede Untätigkeit ein Rätsel und jede Fehlersuche eine Rekonstruktion.
- Bauen Sie den Notaus zuerst. Nachrüsten ist schwerer, weil dann schon Abläufe daran hängen.
Wie ein solches Protokoll im Detail aussieht, beschreibt der Beitrag zu den Säulen eines KI-Audit-Trails, warum die Durchsetzung technisch sein muss, der Beitrag KI-Governance braucht technische Durchsetzung.
Wo die Grenze in Ihrem Prozess liegt
Die Frage ist fast nie, ob ein Sprachmodell gut genug ist. Sie lautet, an welcher Stelle Ihres Ablaufs aus einem Vorschlag eine Handlung wird und wer diese Stelle kontrolliert. Wenn Sie einen KI-Agenten planen oder schon einen im Einsatz haben, gehen wir diese Stelle gemeinsam durch: Potenzial-Check buchen. Wir schauen auf Ihren konkreten Ablauf, nicht auf ein Schaubild.
Quellen
- Eigenes Experiment derWeisserSchwan, Projektdokumentation und Code (März bis Mai 2026, archiviert)
- OWASP Top 10 for LLM Applications 2025, LLM06: Excessive Agency
- Verordnung (EU) 2024/1689 (KI-Verordnung), Art. 12 und Art. 14